新しいAIのモデルが出るたびに、開発元は「主要なベンチマークで最高得点」と発表します。ベンチマークは、AIに同じ問題を解かせて点数を比べるための共通の試験です。
しかし、どのモデルも最高得点をうたうので、使う側にはどれが自分の仕事に合うのかが分からなくなっています。新しいAIが出るたびに最高得点が並ぶのに、なぜどれが良いのか分からなくなったのでしょうか?
AIの点数を比べる試験の多くが、満点近くまで解かれてしまったから
AIの点数を比べてきた試験の多くが満点近くまで解かれ、もう差がつかなくなったため、最高得点の発表を見てもどれが良いかが分かりません。 ペンシルベニア大学ウォートン校のイーサン・モリック教授は2026年11月15日、SatBenchという集計を公開しました。
SatBenchは、2023年以降にAIの開発元が発表で引用してきた173のベンチマークを集め、最高得点が85%に届いたものを「解かれた」と数えています。2026年11月時点で、そのうち109(63%)が解かれていました。モリック教授はXへの投稿で、AIは私たちの測り方より速く良くなっている、と書いています。
新しい試験も、年を追うごとに速く解かれている
では、新しい試験を作れば差は見えるのではないか。新しく作られた試験ほど速く解かれており、差が見える期間は年ごとに短くなっています。 SatBenchによると、公開から1年以内に解かれた試験の割合は以下のとおりです。
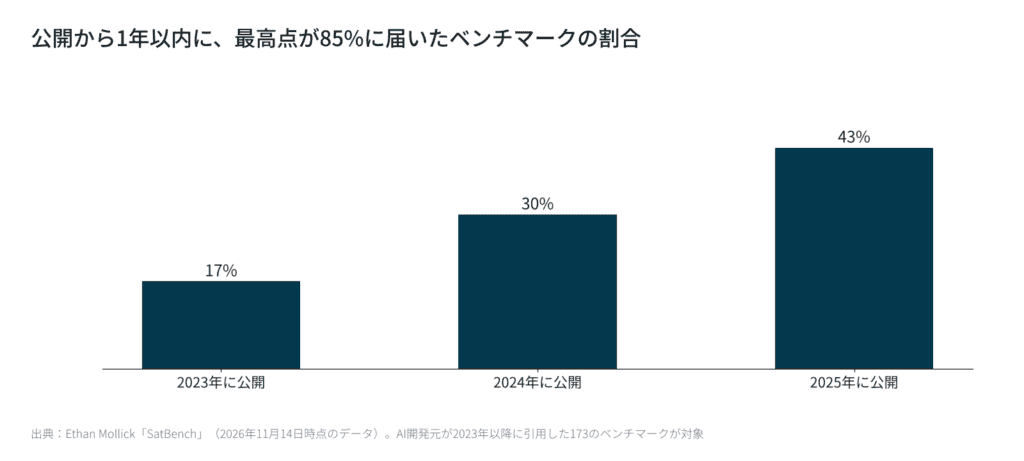
85%に届くまでの期間の中央値も、約20か月から約14か月に縮んでいます。スタンフォード大学のAI Index 2026を紹介したVentureBeatの記事によると、ソフトウェアの不具合を直す試験SWE-bench Verifiedの最高点は、1年で約60%からほぼ100%まで上がりました。
最高得点の多くは開発元が自分で測った数字で、実際の仕事の出来とずれる
では、点数が高ければ実際の仕事でも強いのか。最高得点の多くは開発元が自分で発表した数字で、実際の仕事に近い試験では、まだ人間に届かないものがあります。 SatBenchの集計でも、第三者が確かめた点数だけで数えると、解かれた試験の割合は約24%まで下がります。
AI Index 2026とVentureBeatの記事から、実際の仕事に近い試験の点数を並べると、以下のとおりです。
| 試験 | 何を測るか | AIの最高点 | 人間 |
|---|---|---|---|
| OSWorld | パソコンを操作して作業をこなす | 66.3% | 72.35% |
| ClockBench | アナログ時計の時刻を読む | 50.6% | 90.7% |
| τ-bench | 道具を使い、何往復もやりとりして作業を終える | どのモデルも71%以下 | 記載なし |
VentureBeatの記事によると、AI Index 2026は、広く使われる評価のなかに誤りの割合が最大42%に達するものがあることや、開発元の発表と第三者の検証が食い違う例があることも指摘しています。
使う側は、自分の仕事で実際に試した結果で選ぶ
では、使う側は何で選べばよいのか。使う側にとっていちばん確かな物差しは、自分の仕事の課題をいくつかのAIに解かせて比べた結果だと思います。 試験の点数で上位のモデル同士は差が小さくなっているので、残るのは自分の仕事に向くかどうかの差だと思います。
- 普段の仕事から、答えが分かっている課題を5〜10個選ぶ(過去に自分で書いた報告書の要約、計算の確認など)
- 同じ指示で、候補のAIに解かせる
- 正しさ、直す手間、かかった時間を表にして比べる
- 新しいモデルが出たら、同じ課題で解かせ直す
点数を見るなら、開発元の発表ではなく、第三者が測った結果と、パソコン操作や何往復ものやりとりのように実際の仕事に近い試験の点数を見ると、ずれが小さくなるはずです。次に新しいAIが出たとき、まず自分の課題を5つ解かせてみてはいかがでしょうか。


