新しいAIのモデルが出ると、まず評価の点数が並びます。前の版より何ポイント上がったか、他社のモデルと比べて何位か。
OpenAIが11月17日に公開したGPT-6.2 Astraも、点数では上位に入りました。ところが、公開前から実務で試していたメディア企業Everyの30人のチームは、「誰もAstra 6.2を好きにならなかった」とXに書きました。なぜ点数と実務の評価が逆になったのでしょうか?
Everyのチームが見ていたのは、文章の読みやすさと最後まで任せられるか
Everyのチームが確かめたのは、文章が読みやすいか、作業を最後まで止まらずに進めるかでした。評価の点数が主に測るのは、決まった課題に正しく答えられるかなので、見ているところがそもそも違ったのだと思います。
EveryのCEOのダン・シッパー氏の評価をまとめたBigGo Financeによると、いちばんの不満は文章でした。簡潔にしようとしすぎて文と文がつながらず、記事の書き出しの1文が読みにくいと言っています。コーディングでは、作業の選び方や下調べは良かったものの、最初から最後まで作り切る作業で途中で止まることが多かったそうです。デザインは、どれも同じに見えたといいます。
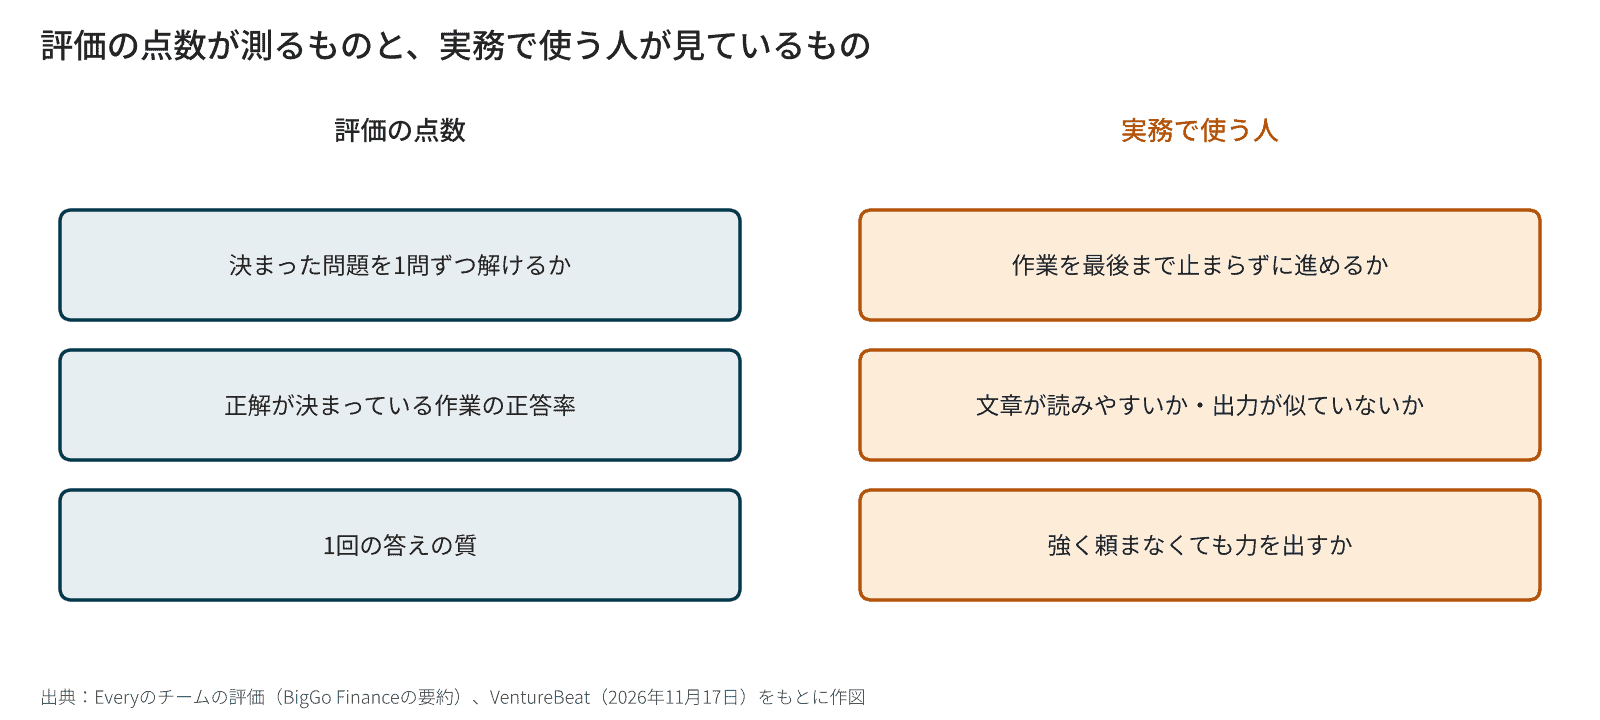
Everyが社内で使っているシニアエンジニア向けの試験でも、点数は約39で、前の版のAstra 6と変わりませんでした。AnthropicのClaude Fable 5.2、Opus 5.5、Sonnet 5.5は40〜41です。シッパー氏は、Astra 6.2は慎重すぎて、強く頼まないと本気を出さないとも話しています。
GPT-6.2 Astraの点数は、本当に上がっている
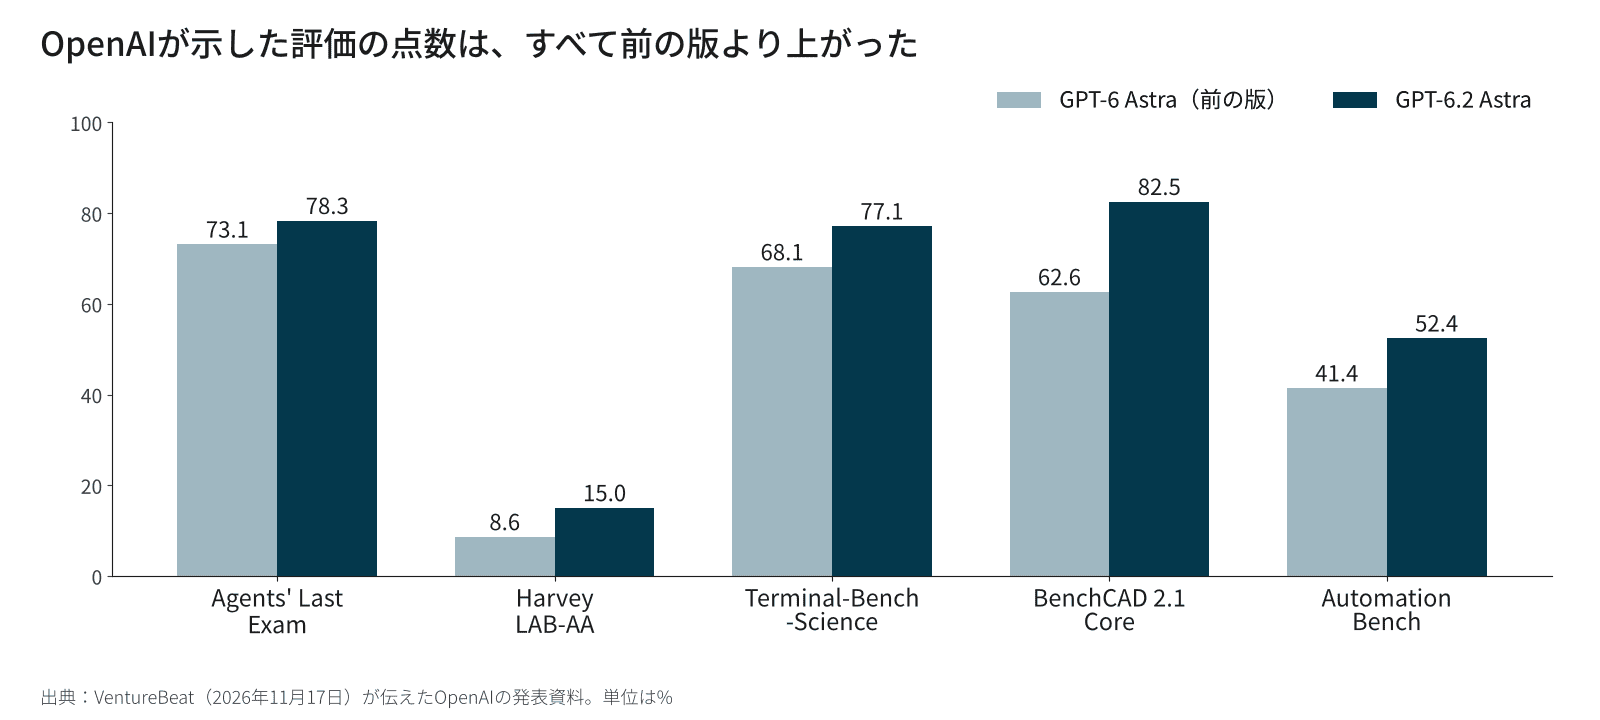
点数が間違っていたわけではありません。OpenAIが示した評価の点数は、どれも前の版より上がっています。
外部の評価機関の結果は、VentureBeatによると次のようになっています。
| 評価 | GPT-6.2 Astraの結果 | 比べた相手 |
|---|---|---|
| Artificial Analysis Intelligence Index | 62点で2位 | 1位はClaude Fable 5.2 |
| Epoch AI | 174点 | Claude Fable 5.2と同点。前の版は169点 |
| Artificial Analysis Coding Agent Index | 横ばい | 前の版から伸びていない |
目を引くのは最後の行です。コーディングを任せたときの総合の指標は伸びていません。点数が上がった評価と、Everyが不満を持った作業は、別のものだった可能性があります。
毎日AIを使う人たちからも、同じ不満が出ている
Everyだけの感想でもなさそうです。VentureBeatによると、AIの開発者のマット・シューマー氏は「ほとんど使えない」と書き、別のモデルに監督させたら作業をやり直されたそうです。開発者のテオ・ブラウン氏は、長い作業を続けさせにくい、あとから何をしたのか分かりにくいと言っています。ペンシルベニア大学ウォートン校のイーサン・モリック教授は「とてもむらがあって奇妙」と評しました。
作った側からも声が出ています。OpenAIの研究者のroon氏は「私は6.2 Astraが大好きだが、それは嫌われたモデルとして生を始めている」とXに書きました。ニュースレター「Don’t Worry About the Vase」のズヴィ・モウショウィッツ氏も、Everyの投稿を引いて「まだとても早い段階だが、Everyには良い実績があり、30人分のデータはかなり決定的だ」と書いています。
AIモデルの良し悪しは、自分の作業で比べる
点数は、条件をそろえて多くのモデルを比べるのには向いています。けれど、文章の読みやすさや、何時間も続く作業を止まらずにやり切るかは、点数ではなかなか見えません。Everyが公開前のモデルを実務で試しているのも、そこを見るためです。
新しいモデルが出たら、先週AIに頼んだ作業から、文章、表、コードを1件ずつ選んで、同じ指示を今のモデルと新しいモデルに渡してみてください。自分で手直しした回数が少ないほうが、その作業での正解です。

