InstagramやFacebookで集客している会社には、ビジネス用のアカウントに自社のWebサイトをつないだり、広告の成果を測るためにサイトにMetaのタグを置いたりしているところも多いと思います。
2026年10月、Metaがビジネス向けの商用規約を改めると告知し、世界のメディアが反発しました。Metaにサイトをつないでいるだけで、なぜ自社サイトの情報までAIの学習に使われうるのでしょうか?
サイトの情報は前から集められている。新しいのは、集めたものをAIの学習に使ってよいと規約に書いたこと
Metaは前から、計測タグとクローラーで会社のサイトの情報を受け取っています。今回の規約案で新しかったのは、ビジネス用のアカウントにつないだサイトを集めて、AIの学習にも使ってよいと契約に書いた点です。
会社のサイトの情報がMetaに渡る主な道は、次のとおりです。
- Metaピクセル:会社が自分でサイトに置く計測用のタグです。PPC Landの解説によると、訪問者がページを見た、商品をカートに入れた、購入した、といった行動を、ページのURLや端末の情報と一緒にMetaへ送ります。Metaはこれを広告の成果の計測と配信の最適化に使います
- facebookexternalhit:Metaのクローラーの説明によると、FacebookやInstagramでリンクがシェアされたとき、リンク先のタイトル、説明文、画像を取りにいくクローラーです
- meta-externalagent:同じ説明で、基盤となるAIモデルの学習などに使うとされているクローラーです。サイトのrobots.txtで断れます
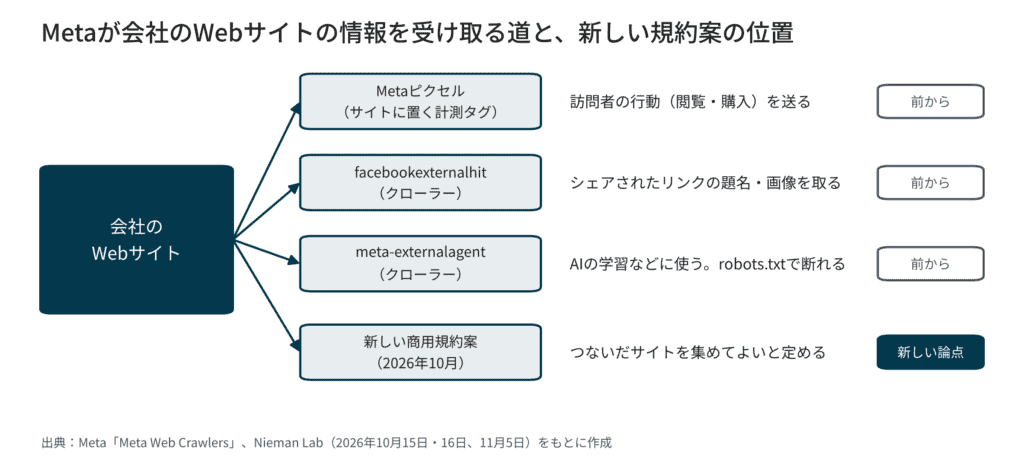
つまり、サイトの情報を集めること自体は新しくありません。Metaは、AIの学習などに使うクローラーはrobots.txtで断れると説明しています。 規約案は、その上に「つないだサイトは集めて使ってよい」という契約を重ねるものでした。
規約案は、断る手段を契約で上書きしうる形だった
では、規約案の何が問題になったのでしょうか。つないだだけで集めてよいことになり、robots.txtで断れるかどうかが、規約の上ではっきりしなくなった点です。
Nieman Labの2026年10月15日の報道によると、規約案は、Metaのビジネス向け製品に「関連付けられた」ドメインやページを、クローラーなどで集め、定期的に更新を取りにいけるとしていました。使い道には、製品の開発・改善に加えて、AIの学習(train)が書かれていました。対象は、Facebookページ、Messenger、Instagram、WhatsAppなどを束ねるビジネス用のアカウントを持つ事業者全般です。
Metaは、robots.txtで断れると説明しました。しかし報道の中で専門家は、新しい規約がrobots.txtの指定より優先されると主張される余地があると指摘しています。規約案には、同意しないならビジネス目的での利用をやめるよう求める文言もありました。
Nieman Labの続報によると、Metaは10月16日に改定版を出し、使い道の一覧から「train」を外して、目的を広告とビジネス向け製品に絞りました。それでも、関連付けられたサイトを自動で集める部分は残りました。弁護士は、「開発(develop)」という語は学習を含むほど広いと見ています。
以下のとおりです。
| 比べる点 | 10月15日に報じられた規約案 | 10月16日の改定版 |
|---|---|---|
| 関連付けられたサイトを自動で集める | できる | できる |
| 使い道に「学習(train)」 | 書かれていた | 削られた |
| 使い道の範囲 | Metaの製品全体 | 広告とビジネス向け製品 |
| robots.txtを尊重する旨の記載 | なし | なし |
規約案はいま止まっているが、取り下げられたわけではない
では、この規約はもう始まっているのでしょうか。2026年11月17日時点では、始まっていません。止まっているだけで、出し直される可能性は残っています。
発効日は当初の10月30日から11月20日へ延ばされていました。AdverTimesは、英国出版社協会など各国のメディア団体が反対の書簡を送ったと伝えています。
その後、Nieman Labの11月の報道によると、Metaは11月5日に改定を無期限で止め、11月20日には発効しないとしました。今の規約がそのまま有効です。
規制当局と裁判所も動いています。英国の競争・市場庁(CMA)は10月30日、Metaの取引条件の調査を始め、事業者が自社のコンテンツを使わせるかどうかを選べない点を懸念として挙げました。ノルウェーとブラジルの裁判所も、メディア団体の申し立てを受けて規約の差し止めを命じたと報じられています。
Metaで集客する会社が、いま確かめておくこと
では、集客でMetaを使っている会社は、何をすればよいのでしょうか。どの道で何がMetaに渡っているかを書き出し、AIの学習用のクローラーを断るかどうかを、規約が出し直される前に決めておくことです。
- ビジネス用のアカウントに、どのドメインとページがつながっているかを書き出す
- Metaピクセルを置いているページと、送っているイベント(購入、問い合わせなど)を確かめる
- 自社サイトのrobots.txtで、meta-externalagentを断るかどうかを決める。断っても、リンクのプレビュー(facebookexternalhit)は止まらない
- 会員限定のページや、外に出したくない資料のページが、つないだドメインの下にないかを見る
次にMetaから規約の変更の通知が届いたら、「関連付けられた」サイトの扱いと、使い道の一覧の2か所を読んでみてはいかがでしょうか。 同意するかどうかを決めるのに要るのは、その2か所だと思います。


